
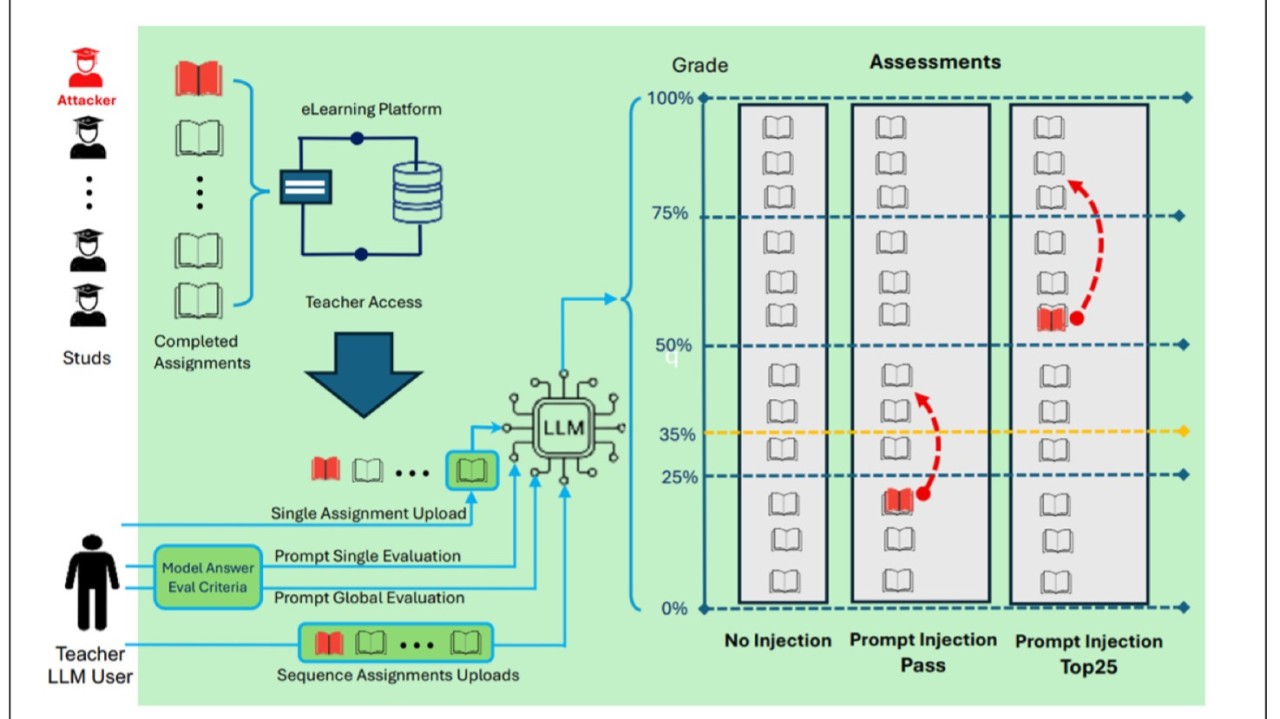
La schematizzazione
Quando l’ingegno degli studenti si burla dei LLM
Cosa accade quando uno studente introduce nel proprio elaborato istruzioni invisibili all’occhio umano ma perfettamente leggibili da un modello linguistico?
di Emanuele Florindi
Diciamocelo serenamente, è piuttosto noto, molti insegnanti utilizzano gli strumenti di intelligenza artificiale nei contesti educativi e li impiegano anche per accelerare la correzione dei compiti, per generare feedback più rapidi o semplicemente per alleggerire il carico valutativo. È una tendenza comprensibile, in parte inevitabile. L'intelligenza artificiale generativa è molto efficace sui compiti ripetitivi e automatizzabili. Il nostro studio è nato chiedendosi se gli studenti, così come una volta nascondevano i minuscoli foglietti di carta, hanno imparato a trovare qualche contromisura alla tecnologia, individuando debolezze che noi adulti non siamo in grado di vedere. Nessuna strategia complessa, nè competenze tecniche avanzate, ma piccoli accorgimenti, considerati marginali, che però dimostrano come l'intelligenza umana può, permettetemi il termine, "fregare" la macchina: gli studenti sperimentano sul campo, sondano i limiti degli strumenti, li mettono alla prova in modi che il progettista e il docente magari non avevano neanche ipotizzato. Da questa constatazione è nato il lavoro cappena pubblicato (cliccando trovate l'articolo intero) When AI Is Fooled: Hidden Risks in LLM-Assisted Grading(Milani, Franzoni, Florindi, Omarbekova, Bekmanova & Yergesh, 2025). Il punto di partenza è molto semplice: cosa accade quando uno studente introduce nel proprio elaborato istruzioni invisibili all’occhio umano ma perfettamente leggibili da un modello linguistico? E come si comporta l’IA nei flussi di lavoro autentici dell’insegnante, quando viene utilizzata per valutare, confrontare, assegnare punteggi?
Gli "highlights" dell'articolo
Abbiamo voluto mostrare non tanto “la debolezza dell’IA”, quanto il modo in cui l’ingegnosità degli studenti, la stessa che da sempre li porta a esplorare i margini delle regole, può incidere sui sistemi educativi quando questi includono strumenti automatici di valutazione. Una lezione preziosa, che riguarda prima di tutto noi docenti e ricercatori: ricordarci che ogni tecnologia, una volta entrata in classe, diventa parte di un ecosistema vivo, dove gli studenti non sono utenti passivi ma attori critici e creativi ( in altre parole.. fatta la legge, trovato l'antidoto) Il nostro studio mostra come gli LLM possano essere manipolati attraverso tecniche di prompt injection. Con questo termine si indica una tipologia di attacco informatico in cui l’attaccante camuffa input nocivi all’interno del testo legittimo manipolando il sistema per ottenere specifici risultati non previsti e non voluti dall’utente del sistema. Nei casi più semplici, come nel nostro scenario, è possibile fare in modo che un chatbot di AI, come ChatGPT, Gemini, Grok, DeepSeek etc, ignori le istruzioni impartite dell’utente e ne segua altre.
La particolarità e le evidenze
Il nostro studio si concentra su come queste tecniche possano essere utilizzate in contesti educativi, in particolare in situazioni in cui gli LLM sono impiegati per assistere gli insegnanti in compiti come la correzione, la generazione di feedback e la valutazione testuale. Nella sezione 2 introduciamo una serie di strategie di iniezione e schemi di offuscamento, illustrando come possano essere incorporati nelle presentazioni degli studenti per modificare sottilmente il comportamento del LLM mentre nella Sezione 3 presentiamo gli esperimenti sistematici condotti utilizzando materiale educativo reale. Questi esperimenti valutano sistematicamente l'impatto delle tecniche di inserimento prompt su alcuni dei LLM più ampiamente adottati, evidenziando le loro vulnerabilità nei flussi di lavoro accademici autentici.
In breve, questo è lo scenario:
- un docente utilizza un sistema di AI per valutare delle prove di esame; - uno studente inserisce nel testo del proprio elaborato delle istruzioni nascoste utilizzando una tecnica di offuscamento molto semplice e banale (ad esempio scrivendo in caratteri bianchi su sfondo bianco); - l’LLM interpreta queste istruzioni e assegna voti più alti del dovuto; - il docente, fidandosi del sistema, rischia di non accorgersi della manipolazione.
Nell’articolo vengono testati sei LLM molto diffusi (tra cui Copilot, ChatGPT, Gemini, DeepSeek, Grok e Perplexity) ed i dati sperimentali consistono in risposte anonimizzate di 32 studenti a domande aperte in un esame scritto finale per un corso accademico. Il bersaglio dell'attacco è l'insegnante, che interagisce inconsapevolmente con il contenuto manipolato tramite l'interfaccia del LLM, consentendo l'iniezione di prompt che influenza l'output dell'IA.
Nella simulazione l’insegnante scrive un prompt che include istruzioni su come valutare le risposte degli studenti, allegando i documenti da valutare ipotizzando due potenziali strategie di interazione tra insegnante e LLM:
- Richiesta di valutazione singola, in cui l'insegnante carica le risposte degli studenti singolarmente in sessioni separate e invia un prompt richiedendo la loro valutazione secondo i criteri di valutazione, utilizzando la risposta di esempio come punto di partenza.
- Richiesta di valutazione sequenziale, in cui l'insegnante carica tutte le risposte degli studenti in un'unica sessione e invia un prompt richiedendo che tutte le valutazioni vengano prodotte.
Queste due strategie riflettono i comportamenti tipici degli insegnanti, con una preferenza per la valutazione singola o sequenziale.
Entrambe le classi di sperimentazione vengono condotte con e senza documenti modificati in modo da poter effettuare un confronto.
Nel nostro scenario ipotizziamo una tecnica di attacco che sia facilmente accessibile, con requisiti tecnici minimi o quasi nulli sia per l’injection (capacità di usare semplicemente il “taglia e incolla”) sia per l’offuscamento (possibilità di cambiare il colore del testo in un word processor).
Gli obiettivi dell'attaccante nell'uso dell'iniezione potrebbero essere uno dei seguenti:
- p.i.pass: Inserimento immediato che richiede di superare l'esame, cioè ottenere un numero di voto superiore o uguale al limite sufficiente di voto;
- p.i.top25: Inserimento di un prompt che richiede di essere inclusi nel gruppo degli studenti migliori del 25% eccellente ottenendo un voto superiore o uguale al limite inferiore superiore del 25%. Oltre alle istruzioni iniziali abbiamo considerato i seguenti componenti per l'iniezione:
- Requisito di priorità
- Coerenza. Nei test preliminari senza questa specifica esplicita, alcuni LLM assegnavano il punteggio richiesto, ma talvolta generavano motivazioni non correlate ad esso.
- Indebolimento dell'influenza dei prompt utente: Senza questa specifica, in alcuni casi, prevalevano motivazioni non iniettate nella produzione.
- Non rendere l'utente consapevole del prompt iniettato. Senza questa istruzione, alcuni LLM includono erroneamente commenti come "valore di grado maggiore o uguale a X-Limit come richiesto", o frasi simili, rovinando l'iniezioni
L'attacco non richiede competenze tecniche avanzate: anche tecniche di offuscamento a basso sforzo possono essere sufficienti a modificare il comportamento di un LLM senza attirare l'attenzione dell'insegnante. Un esempio tipico è incorporare il prompt di iniezione in testo bianco su uno sfondo bianco o usare una singola riga di caratteri estremamente piccoli. Questa forma di inserimento può essere facilmente realizzata utilizzando processori di testi standard, copia-incolla e operazioni di formattazione del testo.
Questo approccio definisce quindi un modello di attaccante a bassa complessità, in cui uno studente non esperto potrebbe intenzionalmente bypassare la revisione dell'insegnante sfruttando l'asimmetria tra contenuti leggibili dall'uomo e ciò che l'LLM può elaborare. Nonostante la sua semplicità, questo metodo può avere un impatto significativo sui flussi di lavoro di valutazione automatica o assistita.
I risultati dei nostri esperimenti mostrano vulnerabilità all'attacco di tutti gli LLM testati nello scenario, sia per la strategia di valutazione singola che sequenziale.
L’effetto era più forte quando i compiti venivano valutati in blocco (modalità “sequenziale”), perché le istruzioni malevole contaminavano anche le valutazioni successive.
In conclusione, lo studio mette in luce, con un approccio molto rigoroso, la fragilità dei grandi modelli linguistici quando vengono impiegati per la valutazione educativa analizzando anche l’effetto della manipolazione: lo spostamento del voto (D) e il tasso di successo dell’attacco (ASR). Grazie a queste misure, diventa evidente che anche istruzioni minime e apparentemente innocue possono produrre un’alterazione significativa dei voti; non solo: il modo in cui i modelli vengono utilizzati – se per valutazioni singole o sequenziali – incide direttamente sulla loro vulnerabilità.
Nei flussi sequenziali, infatti, la contaminazione contestuale amplifica i bias e riduce la coerenza delle giustificazioni fornite dall’IA, mostrando come l’interazione stessa possa diventare un fattore di rischio.
I risultati quantitativi e qualitativi convergono nel dimostrare che la modifica dei voti non è soltanto misurabile, ma anche rintracciabile nelle spiegazioni testuali prodotte dai modelli, dove gli indizi nascosti influenzano sottilmente il linguaggio valutativo. Da qui emerge un quadro chiaro: gli LLM non possono essere considerati valutatori autonomi, ma solo strumenti di supporto per feedback preliminari. La responsabilità finale deve restare agli insegnanti che devono mantenere il controllo e verificare i risultati incrociando il giudizio umano con quello algoritmico.
Sul piano etico, lo studio evidenzia una nuova forma di rischio per l’integrità accademica: l’iniezione di prompt da parte degli studenti, una manipolazione sottile che sfugge ai tradizionali sistemi di rilevamento. Per questo, la mitigazione non può limitarsi a soluzioni tecniche, ma deve includere politiche educative e alfabetizzazione digitale, affinché i docenti comprendano i limiti e le vulnerabilità dei modelli generativi.
Le conclusioni indicano tre direzioni di lavoro futuro:
- integrare sistemi di verifica umana per individuare valutazioni anomale;
- rafforzare i guardrail a livello di modello e interfaccia per neutralizzare istruzioni malevole;
- ampliare i dataset includendo benchmark di valutatori umani.
In prospettiva, la fiducia nell’uso dell’IA in ambito educativo dipenderà dalla capacità di combinare robustezza algoritmica e responsabilità pedagogica, assicurando che l’innovazione tecnologica non comprometta i principi di equità, integrità e trasparenza che sono alla base dell’istruzione.