
Small LM
Gli Small Language Model tra aspettative, prestazioni e democratizzazione dell’IA
Nel giro di pochi anni, il panorama degli Small Language Models si è trasformato profondamente. Oggi tendono sempre più a essere riconosciuti come una famiglia con caratteristiche e finalità proprie.
di Loredana Boero
Nel giro di pochi anni, il panorama degli Small Language Models si è trasformato profondamente. Se in una prima fase questi modelli venivano considerati soprattutto come una riduzione in scala dei grandi modelli linguistici, oggi tendono sempre più a essere riconosciuti come una famiglia con caratteristiche e finalità proprie. La letteratura recente mostra infatti che gli SLM non possono essere descritti semplicemente come una miniaturizzazione degli LLM: se alcuni sono stati sviluppati anche attraverso processi di distillazione o trasferimento di conoscenze da modelli più grandi, altri sono concepiti fin dall’origine come modelli compatti, pensati per contesti in cui efficienza, costo e accessibilità costituiscono vincoli decisivi.
Cosa rende "small" un modello linguistico
Ma che cos'è un modello linguistico piccolo? Un SLM è definito come un modello Trasformers decoder-only con un numero di parametri inferiore - da milioni a pochi miliardi - rispetto ai modelli di grandi dimensioni. È importante sottolineare che la categoria degli Small Language Models non corrisponde ad una soglia parametrica universalmente condivisa, perché la nozione di “piccolo” è relativa e dipende sia dal contesto storico sia da quello applicativo. Da un lato, ciò che in una fase dello sviluppo dei modelli veniva considerato “large” può essere riclassificato come “small” pochi anni dopo, man mano che la scala dei modelli di riferimento aumenta; dall’altro lato, la stessa dimensione in parametri può risultare “piccola” o “grande” a seconda delle risorse disponibili - hardware, budget, vincoli di deployment - e delle aspettative prestazionali del caso d’uso (Nguyen et al., 2024). Per questo, la letteratura non converge su un unico cut-off: alcune definizioni propongono soglie più restrittive - ad esempio nell’ordine di < 1B parametri (ndr: B sta per billion/miliardo in inglese)- mentre altre adottano una definizione più elastica che include modelli nell’ordine di alcuni miliardi di parametri, ad esempio 3B–5B, e in certi contesti anche la fascia 7B (Wang et al., 2025; Lu et al., 2025).
Per dare solo un ordine di grandezza: un modello da 1B o 3B parametri resta comunque molto più piccolo di LLM di riferimento come GPT-3, che aveva 175 miliardi di parametri, o Llama 3.1, disponibile anche nella versione da 405 miliardi. In termini grezzi, significa parlare di modelli che possono essere decine o anche centinaia di volte più compatti. In altre parole, “small” non è soltanto una proprietà intrinseca del modello, ma un’etichetta che emerge dal rapporto fra la dimensione del modello e l’ambiente in cui lo si vuole far funzionare.
Perché più piccoli non significa semplicemente “meno capaci”
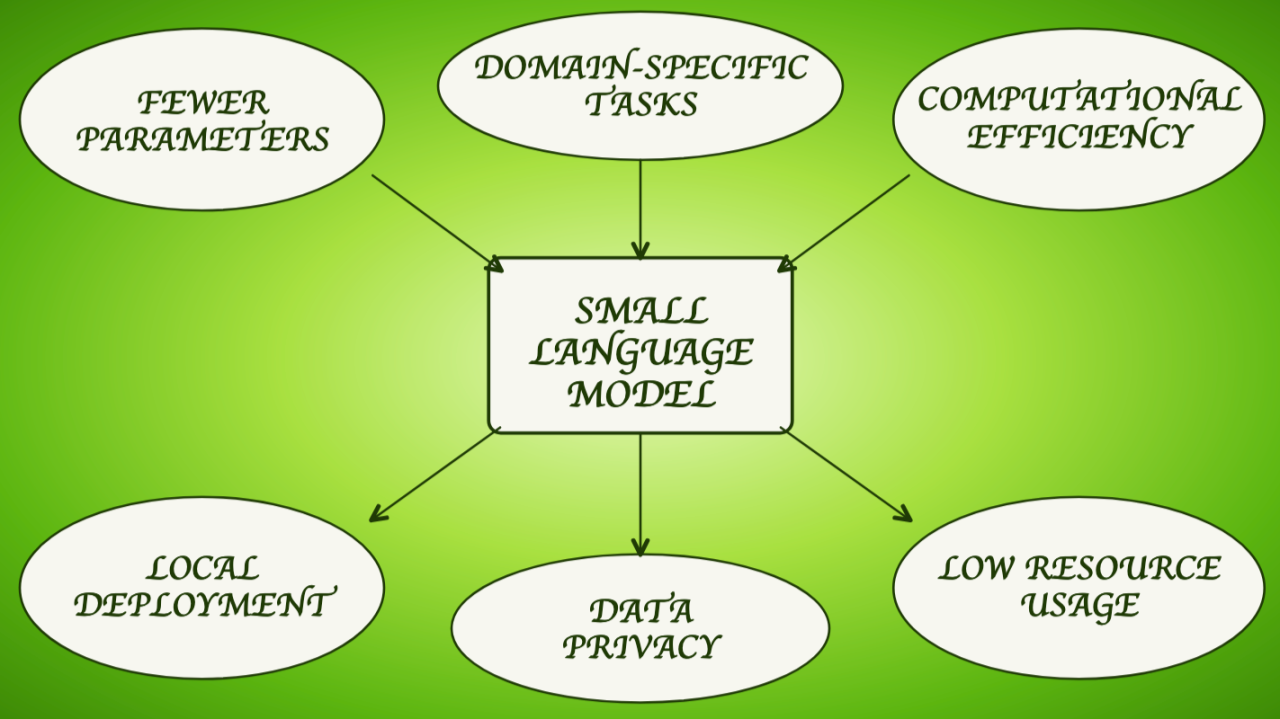
Non bisogna dunque cadere nella semplificazione secondo cui, essendo più piccoli, gli SLM sarebbero soltanto modelli che “fanno meno” rispetto agli LLM. Una lettura di questo tipo rischia di essere fuorviante, perché trascura il fatto che gli Small Language Models rispondono a una logica progettuale in parte diversa. Ciò che li caratterizza, infatti, non è soltanto la compattezza, ma un insieme di proprietà che li rende particolarmente adatti a scenari applicativi specifici: minore costo computazionale, maggiore accessibilità, privacy, uso on-device, sostenibilità, personalizzazione ed è per questo che spesso vengono scelti in ambiti come quello della sanità e dell’struzione. La survey condotta da Lu et al. (2025) mostra con chiarezza quanto rapidamente questo settore si sia evoluto. Gli autori analizzano circa settanta modelli open source, prendendo in considerazione non solo la loro architettura e i dati di addestramento, ma anche il loro comportamento nei benchmark e in condizioni di esecuzione reali. Il dato più interessante è forse proprio questo: nel caso degli SLM, valutare un modello non significa soltanto chiedersi quanto “sappia”, ma anche quanto efficacemente riesca a operare in termini di latenza, uso della memoria e adattamento all’hardware disponibile. Da questo punto di vista, tra il 2022 e il 2024 il miglioramento è stato notevole e alcuni modelli recenti hanno raggiunto prestazioni sorprendentemente solide in rapporto alla loro scala.
Il nodo decisivo: la qualità dei dati
Un punto resta decisivo: la qualità dei dati. Per modelli di scala ridotta, infatti, la costruzione del corpus non è un elemento secondario, ma una variabile decisiva. Dataset aperti utilizzati nel pretraining, come FineWeb-Edu e DCLM, sembrano offrire risultati particolarmente promettenti, anche in virtù di procedure di filtraggio basate su modelli, che permettono una selezione più accurata dei dati.
Questo aspetto ha anche una conseguenza rilevante sul piano applicativo: i modelli di dimensioni ridotte, richiedendo meno risorse computazionali, sono generalmente più facili da adattare e specializzare. La minore complessità del fine-tuning e dell’inferenza li rende infatti particolarmente adatti a contesti in cui si voglia costruire un modello mirato, calibrato su un dominio o su una funzione specifica.
Ma come orientarsi fra i diversi SLM? Pham et al. (2025), propongono un benchmark in cui le prestazioni vengono considerate insieme a costo computazionale, consumo energetico e impatto ambientale. La prospettiva adottata è quindi più ampia di quella dei benchmark tradizionali: nel caso degli SLM, infatti, non è sufficiente chiedersi quanto bene un modello risponda, ma anche a quale costo riesca a farlo.
Per rendere possibile questo tipo di confronto, gli autori costruiscono un quadro di valutazione molto articolato, che coinvolge quindici modelli open source, nove task di NLP, ventitré dataset, quattordici domini applicativi e quattro configurazioni hardware. I task considerati spaziano dal question answering alla classificazione, dalla comprensione del testo alla generazione, mentre i domini coprono ambiti molto diversi, dalla matematica al diritto, dalla sanità al customer support. Il benchmark utilizza undici metriche, distribuite in tre grandi aree: prestazione, computazione e consumo. L’obiettivo non è individuare un vincitore assoluto, ma mettere in luce i trade-off che caratterizzano i diversi modelli. Alcuni risultano più forti sul piano dell’accuratezza, altri mostrano una maggiore efficienza computazionale, altri ancora si distinguono per un minore impatto energetico. In questa prospettiva, il paper suggerisce che non esista uno Small Language Model migliore in senso universale, ma piuttosto modelli più o meno adatti a seconda che si voglia privilegiare la qualità della risposta, la velocità di esecuzione o la sostenibilità del sistema.
Scegliere il modello giusto per il contesto giusto
Il valore del lavoro sta proprio nello spostare l’attenzione da una domanda astratta — quale modello performa meglio — a una domanda più concreta e applicativa: quale modello conviene effettivamente adottare, se si considerano insieme qualità, costo e consumo. Si tratta di un cambio di prospettiva particolarmente rilevante nei contesti reali e in ambienti a risorse limitate, dove memoria, budget, latenza ed energia disponibili costituiscono vincoli decisivi. Gli stessi autori riconoscono alcuni limiti, soprattutto per quanto riguarda la dipendenza dei risultati dall’hardware e il fatto che le stime su energia e CO₂ non derivino ancora da misurazioni dirette. Resta però molto chiaro il messaggio di fondo: valutare gli SLM significa ormai misurare non solo ciò che sanno fare, ma anche quanto efficientemente e sostenibilmente riescono a farlo.
Come mostrano Pham et al. (2025), non esiste uno Small Language Model migliore in senso universale: i risultati cambiano a seconda che si privilegi l’accuratezza, l’efficienza computazionale o la sostenibilità energetica. Nel loro benchmark, ad esempio, Llama-3.2-1B emerge come particolarmente forte sul piano della correttezza, GPT-Neo-1.3B si distingue per l’efficienza computazionale, Phi-1.5B per il consumo energetico, mentre Mistral-7B appare come uno dei modelli più equilibrati nel rapporto complessivo tra prestazioni, costo e consumo. In questa prospettiva, la scelta di un SLM non può essere astratta o puramente gerarchica, ma deve dipendere dagli obiettivi concreti del contesto d’uso: rapidità di esecuzione, contenimento dei costi, sostenibilità, deployment locale o qualità della risposta.
Perché gli SLM diventano centrali anche nell’AI agentica
In questa direzione si colloca il position paper di Belcak et al. (2025), che formula una tesi molto netta: nei sistemi di AI agentica, gli Small Language Models sono destinati ad assumere un ruolo sempre più centrale. Il punto di partenza degli autori è che molte chiamate al modello, all’interno di un agente, non richiedono tutta la capacità generale di un grande LLM, perché riguardano compiti ripetitivi, delimitati e relativamente prevedibili. In questi casi, sostengono gli autori, gli SLM risultano spesso non solo sufficienti, ma anche più adatti sul piano operativo, più economici e più efficienti.
Che questo mutamento non appartenga più soltanto alla riflessione teorica, ma sia già entrato nell’orizzonte strategico delle organizzazioni, emerge con chiarezza anche dal report IBM Institute for Business Value (2025). Il documento mostra bene come una parte significativa del mondo imprenditoriale abbia già recepito l’idea che il futuro dell’AI non coinciderà necessariamente con il modello più grande, ma con il modello più adatto a uno specifico contesto d’uso.
Dalla strategia d’impresa alla democratizzazione dell’intelligenza artificiale
Il report insiste infatti sulla crescente centralità di architetture multi-model, sull’importanza di combinare modelli diversi in funzione dei compiti da svolgere e sul valore strategico di soluzioni più leggere, specializzabili e integrabili anche in ambienti con vincoli di costo, latenza e infrastruttura. In questa prospettiva, gli SLM appaiono sempre più come uno strumento concreto di efficienza, adattabilità e accessibilità, tanto che una larga parte dei dirigenti intervistati si aspetta che essi acquisiscano, nei prossimi anni, un ruolo sempre più rilevante all’interno delle proprie organizzazioni. Il punto, allora, non riguarda più soltanto ciò che gli Small Language Models possono fare sul piano tecnico, ma anche il modo in cui possono ridisegnare l’accesso stesso all’intelligenza artificiale, rendendola più distribuibile, più personalizzabile e potenzialmente più democratica. Se il mondo delle imprese sembra avere già colto questa trasformazione, resta aperta una domanda forse ancora più importante: che cosa farà il settore dell’istruzione di fronte a questo scenario? E soprattutto: in che modo saprà avvalersi del potenziale di democratizzazione offerto dagli SLM? Su questo terreno, il futuro resta ancora da scrivere.
Bibliografia
Belcak, P., Heinrich, G., Diao, S., Fu, Y., Dong, X., Muralidharan, S., Lin, Y. C., & Molchanov, P. (2025). Small language models are the future of agentic AI. https://doi.org/10.48550/arXiv.2506.02153
Chen, Y., Zhao, J., & Han, H. (2025). A survey on collaborative mechanisms between large and small language models. arXiv preprint arXiv:2505.07460. 2505.07460
Corradini, F., Leonesi, M., & Piangerelli, M. (2025). State of the art and future directions of small language models: a systematic review. Big Data and Cognitive Computing, 9(7), 189. https://doi.org/10.3390/bdcc9070189
IBM Institute for Business Value. (2026, January 16). The enterprise in 2030. https://www.ibm.com/thought-leadership/institute-business-value/en-us/report/enterprise-2030
Thanh Pham, N., Kieu, T., Nguyen, D. M., Xuan, S. H., Duong-Trung, N., & Le-Phuoc, D. (2025). SLM-Bench: A Comprehensive Benchmark of Small Language Models on Environmental Impacts--Extended Version. arXiv e-prints, arXiv-2508. 2025.findings-emnlp.1165.pdf
Prieto, P., & Abad, P. (2025). Edge deployment of small language models, a comprehensive comparison of CPU, GPU and NPU backends. https://arxiv.org/abs/2511.22334
Sharma, R., & Mehta, M. (2025). Small language models for agentic systems: A survey of architectures, capabilities, and deployment trade offs. https://arxiv.org/abs/2510.03847
Van Nguyen, C., Shen, X., Aponte, R., Xia, Y., Basu, S., Hu, Z., ... & Nguyen, T. H. (2025, September). A Survey on Small Language Models. In Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing-Natural Language Processing in the Generative AI Era (pp. 807-821). https://arxiv.org/abs/2410.2001