
summer school unimore
L’IA non è neutrale. Evidenze e intuizioni dalle Digital Humanities
Linguistica dell'IA... una questione da approfondire con gli studi più recenti
di Alice Pierluigi
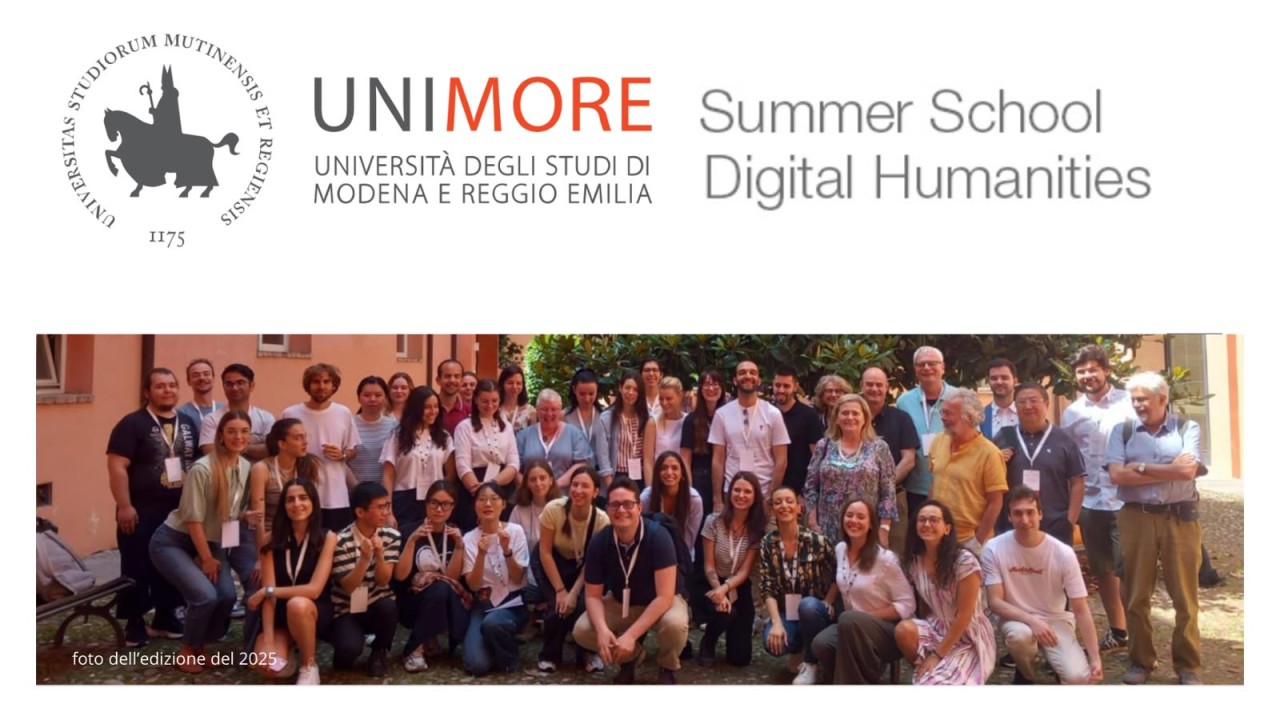
L'intelligenza artificiale può essere definita una tecnologia neutrale, uno strumento capace di elaborare informazioni, produrre testi, generare immagini o tradurre contenuti senza prendere posizione sul mondo che rappresenta? È proprio da questa domanda che sono partite molte delle riflessioni emerse durante la Summer School in Digital Humanities e Digital Communication, ospitata questa settimana nella magnifica cornice del Dipartimento di Studi Linguistici e Culturali dell'Università degli Studi di Modena e Reggio Emilia. Per cinque giorni, più di 9 docenti e 28 dottorandi e giovani ricercatori provenienti da tutto il mondo si sono confrontati sugli usi e i disusi dell'intelligenza artificiale nella ricerca accademica, nelle digital humanities e nella comunicazione digitale.
Per rispondere alla questione della neutralità dell’IA, considerando che essa si basa fondamentalmente su dati linguistici, bisogna prima fare un passo indietro e chiedersi se le lingue stesse siano neutrali.
La neutralità linguistica non esiste
La prof.ssa Lynne Bowker dell'Université Laval ci ricorda che, nel corso della storia, diverse lingue hanno svolto il ruolo di lingua franca. In passato, nell'Europa occidentale furono prima il greco e il latino; in altri contesti geografici l'arabo, il persiano, l'aramaico o il sanscrito. Dalla seconda metà del Novecento, invece, questo ruolo è stato progressivamente assunto dall'inglese. Potremmo essere portati a considerare questa evoluzione come qualcosa di naturale o neutro. In realtà, la scelta di una lingua franca è tendenzialmente il risultato di fattori storici, economici, sociali e geopolitici. Ciò che è certo è che nessuna lingua “naturale” è davvero “neutrale”. A meno che non si usino lingue appositamente create (come il caso dell’esperanto, ad esempio), qualunque lingua venga scelta, esisteranno sempre persone che la parlano come madrelingua e che, proprio per questo, partiranno da una posizione di vantaggio rispetto agli altri. Ma perché nel caso della ricerca scientifica, l’inglese può creare delle disuguaglianze? Per rispondere a questa domanda, la prof.ssa canadese riporta dei dati che sono a dir poco indicativi. In vari settori disciplinari più del 90% delle pubblicazioni è in inglese, ma le stime indicano che meno del 6% dei ricercatori che producono tali ricerche è madrelingua inglese (Ammon, 2010; Bargheer & Pabst, 2016).
La situazione diventa problematica perché, per i non madrelingua, leggere un articolo in inglese richiede il 91% di tempo in più (Amano et al., 2023) e difficoltà simili si riscontrano nella scrittura, nelle presentazioni a conferenze e nella revisione degli articoli (Amano et al., 2023). Se un ricercatore impiega sistematicamente più tempo a capire, produrre e comunicare la propria ricerca in inglese, intuiamo come egli abbia automaticamente meno risonanza: potrebbe pubblicare meno, leggere meno, partecipare ad un numero minore di conferenze e revisionare meno articoli. E l'intelligenza artificiale come entra in gioco in questo sistema già sbilanciato? I sistemi di traduzione automatica e i grandi modelli linguistici tendono infatti a funzionare meglio per le lingue che dispongono di grandi quantità di dati e risorse linguistiche. Al contrario, incontrano maggiori “difficoltà” con le lingue meno rappresentate o con i linguaggi altamente specialistici.
In questo senso, l'IA rischia di perpetuare o, addirittura, amplificare delle dinamiche già esistenti di “disuguaglianza” associate alle lingue. Le tecnologie che utilizziamo ogni giorno riflettono infatti gli equilibri e gli squilibri presenti nei dati su cui sono state costruite.
L'IA stessa non descrive il mondo nello stesso modo degli esseri umani
D’altro canto, sarebbe fuorviante vedere l’IA solo come uno “specchio”. Per capire perché, possiamo ricorrere agli studi della prof.ssa Michaela Mahlberg della FAU Erlangen-Nürnberg e University of Birmingham, la quale ha confrontato racconti scritti da esseri umani con testi narrativi generati da diversi modelli di intelligenza artificiale, tra cui GPT, Mistral e LLaMA, e riscontrato differenze significative nello storytelling dei testi scritti da IA rispetto a quelli scritti da umani. Nei racconti generati dall'IA compaiono con maggiore frequenza quelli che la studiosa definisce perceived spaces: spazi percepiti, osservati e descritti attraverso le sensazioni dei personaggi. Le narrazioni insistono spesso su ciò che viene visto, sentito o percepito. Nei racconti scritti da esseri umani, invece, emerge una dimensione più incarnata (o in inglese embodied). Le percezioni sono certamente presenti, ma lasciano maggiore spazio alle azioni, alle interazioni e ai movimenti dei personaggi all'interno dell'ambiente. I protagonisti non sono semplici osservatori della realtà che li circonda: agiscono con e nell’ambiente. Questa differenza ci porta a una considerazione più ampia riguardo il fatto che l'IA non si limiti a imitare la scrittura umana. Nel tentativo di riprodurla, finisce, infatti, per costruire una rappresentazione del mondo che presenta caratteristiche proprie. Le storie generate dall'intelligenza artificiale tendono a essere abitate da osservatori; quelle umane, più frequentemente, da attori.
Due possibili soluzioni
Constatata la non-neutralità delle lingue e dell’IA, la domanda che sorge spontanea è: quali possono essere le possibili soluzioni? Per la prof.ssa Bowker, il multilinguismo diventa cruciale, spostando il paradigma da UNA lingua franca a PIÙ lingue veicolari. Per costruire un ecosistema accademico-scientifico più inclusivo a livello linguistico, si richiede sicuramente il coinvolgimento di molteplici attori: ricercatori, istituzioni, journals, società e associazioni scientifiche,... Favorire la pubblicazione in più lingue, adottare metadati multilingue, potenziare le pratiche diversificate di revisione tra pari e sviluppare politiche che valorizzino la diversità linguistica sono tutti passi che possono contribuire a rendere la comunicazione scientifica più inclusiva e accessibile. La seconda proposta arriva dalla prof.ssa e riguarda il modo in cui studiamo il linguaggio e la costruzione del significato. In un momento storico in cui tutti parlano di intelligenza artificiale e linguaggio, diventa necessario sviluppare approcci realmente interdisciplinari, capaci di mettere in dialogo informatica, linguistica, letteratura e scienze umane.
Le Digital Humanities possono svolgere un ruolo importante proprio in questo processo, aiutando, ad esempio, a comprendere come i sistemi di IA “costruiscano” significati, storie e rappresentazioni del mondo o come le “gerarchie” linguistiche si possano amplificare con queste tecnologie e quali meccanismi nuovi si instaurino. Tuttavia, resta un imperativo: affinché ci sia interdisciplinarietà, si invitano gli studiosi a rendere i propri concetti e i propri metodi comprensibili anche al di fuori delle comunità specialistiche. In fondo, le questioni emerse non riguardano soltanto l’intelligenza artificiale… Riguardano il modo in cui noi “umani” produciamo conoscenza, raccontiamo il mondo e costruiamo strumenti per interpretarlo.
Letture suggerite:
Amano, T. et al. 2023. The manifold costs of being a non-native English speaker in science. PLoS Biology 21(7): e3002184. https://journals.plos.org/plosbiology/article?id=10.1371/journal.pbio.3002184
Bowker, L., M. Laakso, and J. Pölönen. 2025. Making the case for multilingual scholarly communication. Canadian Journal of Information and Library Science 48(1): 112-116. https://doi.org/10.5206/cjils-rcsib.v48i1.22292
Burton-Jones, Andrew, et al. 2025. This article is not just in English: Making science more inclusive and impactful with artificial intelligence translation. Australasian Journal of Information Systems 29. https://doi.org/10.3127/ajis.v29.5875
Roland, E., & So, R. J. (2026). Generative AI & Fictionality: How Novels Power Large Language Models (arXiv:2603.01220). arXiv. https://doi.org/10.48550/arXiv.2603.01220
Nieth, B., M. Gracheva, M. Mahlberg, B. Eskofier, and E. Salin. 2026. How Human-Like Are Large Language Models? A Register-Aware Linguistic Evaluation Framework. arXiv preprint arXiv:2605.23651. https://doi.org/10.48550/arXiv.2605.23651
Warburton, Kara. 2024. Developing a business case for managing terminology.
http://termologic.com/wp-content/uploads/2024/05/roi-article-warburton.pd