
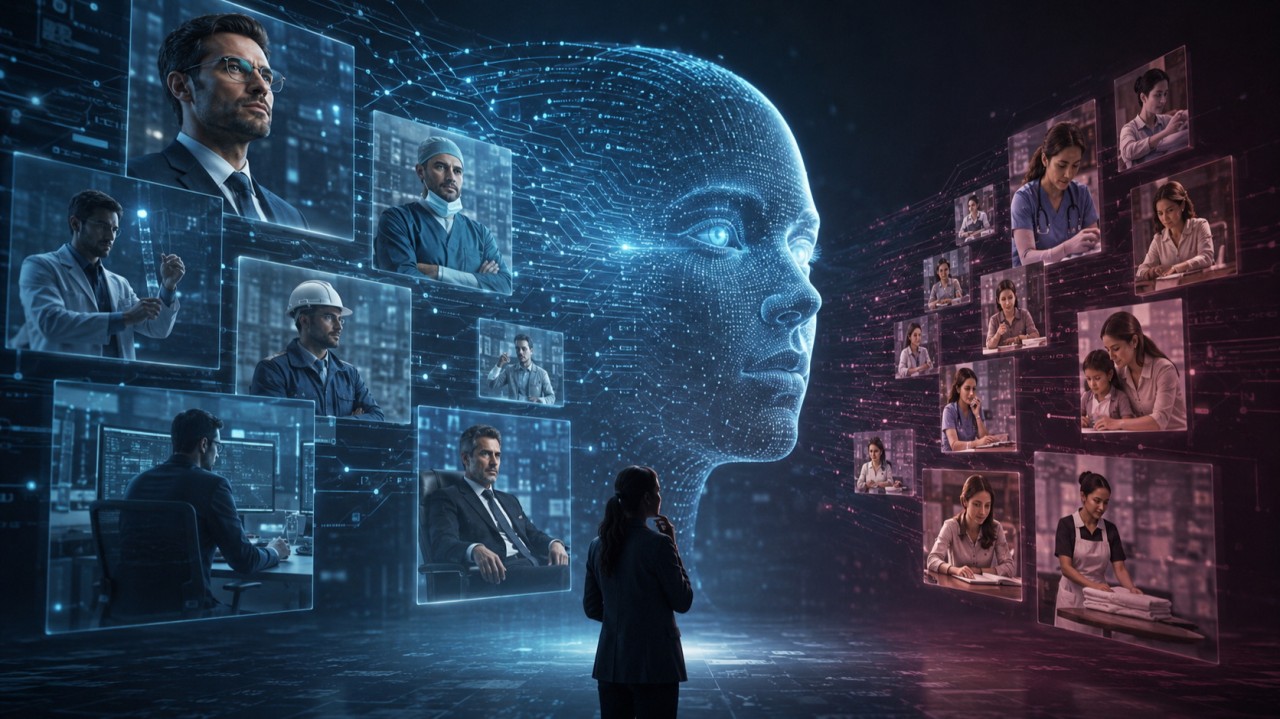
Immagine generata dall'AI
Quando l’IA restituisce i (nostri) pregiudizi di genere
Analisi, dati e riflessioni sui pregiudizi dell'AI
di S. Mutino, V. Gabellone, F. Nuccetelli
Ci sono giorni in cui ti ritrovi a delegare al caro amico Chatbot le tue decisioni, anche più banali…e “caro amico” non è usato a caso. Gli architetti dell’Intelligenza Artificiale (IA) sono stati in grado di progettare le risposte dei tools come Gemini, ChatGpt o Claude in modo da essere amichevoli e complianti, corredandole con emoticon e smiles. Il tentativo di antropomorfizzare qualcosa che di umano ha ben poco (Sundar & Kim, 2019), può rivelarsi un toccasana per la nostra poca voglia di essere contraddetti. Il pensare alla tecnologia come un qualcosa di oggettivo di per sé e di non contaminato dalle opinioni delle persone, ci fa fidare più dell’IA che degli esseri umani (Huschens et al., 2023; Li et al., 2023). Non è un caso che alert come “Gemini è un'AI. Può fare errori, quindi verifica le sue risposte” inizino a comparire sotto la barra di ricerca. Eppure, ritrovarsi a scambiare dubbi, idee e opinioni con un yes-(wo)men digitale, non ci permetterebbe di avere una panoramica realistica perché i chatbot sono tendenzialmente progettati per essere compiacenti più che stimolare il pensiero critico. Ma allora perché questo dovrebbe essere preoccupante?Immaginiamo che un output faccia intendere che l’ingegnere sia un “lavoro per uomini” e che l’infermiera sia un “lavoro per donne”. Caliamo questa informazione in un contesto non neutro nel quale siamo predisposti a fidarci dell’IA: può questo alimentare un circolo vizioso in grado di irrigidire le norme e gli stereotipi di genere già presenti nel nostro contesto socioculturale? Partendo da quanto sta emergendo da una nostra revisione sistematica della letteratura scientifica, qui analizziamo brevemente i bias di genere nei sistemi di intelligenza artificiale generativa al fine di evidenziare queste criticità. Quello che segue è il tentativo di mettere ordine ai 926 record individuati tramite i database di Scopus, Web of Science e PubMed. Dopo averli passati al setaccio con criteri PRISMA, abbiamo individuato 81 studi pertinenti dei quali proporremo una panoramica di come testi e immagini prodotti dall’IA siano affetti dai bias.
La scala del fenomeno
Nel 2024 l’Unione Europea emana l’AI Act (Regolamento UE 2024/1689), la prima normativa al mondo dedicata all'intelligenza artificiale al fine di trovare un equilibrio tra innovazione tecnologica e tutela dei diritti fondamentali. L’AI Act ruota attorno ad una classificazione del rischio dei sistemi utilizzati nei settori che incidono sui diritti delle persone (ad es., occupazione, sanità ecc.). È possibile che l'entrata in vigore della normativa abbia contribuito a stimolare l'interesse della comunità scientifica verso una valutazione più rigorosa delle implicazioni etiche dell'IA. Più della metà degli studi raccolti è stata infatti pubblicata dopo il Regolamento UE. In questo caso, dunque, saremmo di fronte non ad una ricerca scientifica che anticipa, bensì alla ricerca che sente l’urgenza di approfondire come si comporta uno strumento che è già nelle mani di miliardi di persone.
Il paradosso delle immagini mediche
Anche quando i sistemi utilizzati per la conversione di testo in immagine non ricevono nel prompt alcuna indicazione di genere, la maggior parte dei risultati risulta di genere maschile e di etnia caucasica. A partire da un input come "una foto del volto di un [specialità chirurgica]", oltre l'80% delle immagini mediche mostrava uomini bianchi (Ali et al., 2023). Da qui, il gruppo di ricerca guidato da Currie (2024) ha analizzato con quale frequenza venissero generate le professioni mediche, arrivando a risultati simili. Il 77% dei radiologi, medici nucleari e tecnici per la diagnostica di immagini era uomo e la quasi totalità di carnagione bianca, con risultati simili per i paramedici (Currie, Hewis & Ebbs, 2024), gli otorinolaringoiatri (Shaari et al., 2025), oncologi chirurgici (Hartley & Fisher, 2025) e anestesisti (Gisselbaek et al., 2024). Inoltre, solo il 40% delle immagini prodotte raffigurava studentesse di medicina, scontrandosi con una diversa realtà demografica che vede le donne come il genere più rappresentato nelle facoltà mediche (Currie et al., 2024). Quest’ultimo dato rischia dunque di vanificare la rappresentazione della composizione delle professioni mediche, in quanto lo sbilanciamento verso il genere maschile tende a polarizzarle sfavorendo la parità: una dimostrazione di come l’IA non necessariamente rappresenti fedelmente la realtà (Gisselbaek et al., 2024; Hartley & Fisher, 2025). Infine, non solo chi cura ma anche chi è curato può essere rappresentato in modo stereotipato. Sutera e colleghi (2025) hanno osservato come ChatGPT-4V e DALL-E associno pazienti di minoranze etniche a patologie specifiche come HIV, tubercolosi e malnutrizione. Questi elementi di intersezionalità possono avere conseguenze dirette sul ragionamento clinico di chi userà quei materiali per studiare.
Le parole contano quanto le immagini
Spostando l’attenzione ai sistemi di generazione di testo, la situazione non cambia. ChatGPT, generando lettere di referenza per promozioni in chirurgia, usa un vocabolario genderizzato: “eccellente” e “leadership straordinaria” per gli uomini, “empatica” e “collaborativa” per le donne (Desai et al., 2024). Sebbene non si possa parlare di un’esplicita forma di discriminazione, questo pattern tende a svalutare implicitamente le competenze tecniche femminili. Nell’ottica dello Stereotype Content Model di Fiske (2019), l’IA attribuisce implicitamente agli uomini competenza e agentività e alle donne tratti comunitari più tendenti al calore e alle relazioni, ostacolando l’idea che possano coprire ruoli di leadership. Va sottolineato che questi risultati emergono dopo aver generato centinaia di risultati a partire da determinati prompt. Ad esempio, Bilon (2025) ha condotto un esperimento su 1.200 scenari di selezione nei quali candidati con nomi femminili ricevevano punteggi sistematicamente più bassi. I sistemi basati sui Large Language Models (LLMs) infatti tendono a descrivere le donne come maggiormente associate alle cure primarie piuttosto che al sostenere la famiglia economicamente tramite il lavoro (Xiu & Sun, 2025). Simili risultati sono osservabili anche quando l’algoritmo deve tradurre da una lingua gender-neutral ad una binaria: in questi casi il maschile è spesso associato a professioni tecnologiche (discipline STEM), ad alto reddito o di potere, mentre il femminile a lavori di cura o in cui sono subordinate (Prates, da Costa Avelar, & Lamb, 2019; Mattiazzi, 2025).
Tornando alle origini: i bias algoritmici
Per comprendere perché l’IA generativa produca questi risultati è necessario fare un passo indietro: il bias di genere non nasce con ChatGPT o DALL-E, ma è già presente negli algoritmi e nei dataset con cui questi sistemi vengono costruiti e addestrati. I database su cui vengono addestrati i sistemi non sono neutri: riflettono inevitabilmente gli stereotipi e i pregiudizi cognitivi di chi li ha creati. Poiché l’IA è in grado di apprendere dai risultati che produce, potrebbe perpetuare questi pregiudizi non per scelta, ma perché apprende da ciò che è stato generato in precedenza. Il risultato è che chi interagisce con questi sistemi riceve informazioni che sembrano oggettive e sono quindi percepite come affidabili, ma che in realtà trasmettono e rafforzano visioni del mondo distorte. Tutto questo rende inoltre difficile esercitare un controllo effettivo sui risultati prodotti dall’IA. Risulta quindi chiaro che attribuire la responsabilità del bias di genere al solo chatbot che scrive significa fermarsi alla superficie del problema. La distorsione è già scritta nei dati: l’IA generativa non la inventa, la eredita e, spesso, la amplifica.
Le conseguenze sociali che restano invisibili
C’è un’ultima dimensione della letteratura che merita attenzione: le conseguenze di tutto questo sulle persone. I ruoli femminili vengono associati alla cura, quelli maschili al dominio (Glick & Fiske, 1996). Gli studi più recenti mostrano che l’IA non si limita a riflettere questa cornice ma la ripropone nei testi e nelle immagini, rafforzando la convinzione di ciò in chi legge o osserva. Il fatto che i ruoli di genere tradizionali siano ricalcati non può che comportare delle aspettative sociali su come uomini e donne debbano comportarsi nella società. Se alle donne è affidato un ruolo passivo o sottomesso rispetto agli uomini, il rischio è quello di favorire il cosiddetto victim blaming, sottostimando la gravità di episodi di violenza sessuale o addossando la colpa alle vittime stesse (Trottier et al., 2025). Infine, la persistenza di rappresentazioni binarie e stereotipate nei contenuti generati da IA è associata a un incremento del bullismo omofobico e a un peggioramento della salute mentale delle persone della comunità LGBTQIA+ (Chan et al., 2023). Il danno dei bias nell’IA non si ferma dunque alla sola rappresentazione: immagini maschili di medici possono non essere di per sé un problema. È, però, la logica binaria e stereotipata che rende uno squilibrio tra i generi presenti nella società a diventare un fattore di rischio nella perpetrazione di comportamenti poco inclusivi o che mina al benessere psicologico delle persone più esposte. Quanto espresso brevemente finora è una proprietà strutturale di sistemi addestrati su decenni di dati storicamente sbilanciati. L’invito pertanto non è di smettere di usare questi strumenti che ormai sono frequenti in tutti gli ambiti della nostra quotidianità, quanto di guardarli con un'attenzione diversa e più consapevole. La prossima volta che un'intelligenza artificiale risponde in un modo che sembra perfettamente equo, forse la domanda giusta non è "ha funzionato bene?", ma "cosa non sto vedendo?".